有一家叫做 Labs 的人工智能初创公司声称, 他们那个实验性的被称为寒霜的 CPU 架构, 其每瓦性能要比传统的处理器核心高出很多, 具体数值是高了 4 . 59 倍, 而且该架构在单位面积内的性能也表现突出, 达到了比传统核心高出 8 . 77 倍的水平。
这种从头开始就利用人工智能来设计的方案, 采用了一种完全不一样的计算方法, 但是它那些特别引人注目的成果目前还从来没有在实际芯片身上得到验证。
美国那边的一家做人工智能的初创企业, 名字叫Labs, 他们对外宣称说, 自己弄出来的人工智能系统, 是完全从头到尾设计的一种全新的通用形式的中央处理器架构, 这个过程里面包括了指令怎么规定、微观结构咋样设定、RTL代码怎么写、怎么去验证, 还有最后得到的那个GDS布局, 全部都涉及到了, 这家企业还说得很明白, 在面对25种不同的工作状态的时候, 他们新设计出来的那种每消耗一瓦特电所发挥出來的性能, 能够达到传统CPU核心性能的4.59倍那么多, 而在单位面积所具备的性能方面呢, 则是能达到传统CPU核心的8.77倍。
然而, 这些个结果, 它可不是从那些实际物理处理器的真枪实弹的使用当中得出来的, 它只是来自于在芯片还根本没造出来之前进行的仿真模拟工作。
传统的中央处理器和寒霜架构是不一样的, 寒霜()这个架构是建立在一种叫做交互网络()的数学模型当中的, 这种数学模型是在1990年就被提出的。
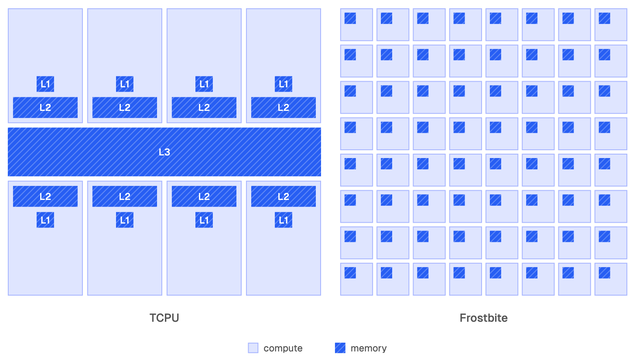
它并不依赖单个大型核心, 而是采用了由小型计算单元所组成的网格结构, 这些小型计算单元会执行那些表现为交互网络形式的程序, 这里需要解释一下交互网络是什么东西, 它是一个图的结构, 在这种图形当中, 计算行为是通过针对连接的节点进行局部重写操作来完成的。
每个计算单元首先要做的是处理属于自己的任务, 等到手头的工作忙完了、有了空闲的时间, 它就会去隔壁的计算单元那里接收更多额外的工作过来执行, 要是它周围都没有任何可做的活儿了, 那它就进入一种不活动的状态里去, 这么一来就可以达到节约电量的目的, 采用这种属于分布式的方法是因为不需要依靠那些集中的调度器来进行安排, 其主要的目的是为了让整体的架构在规模不断变大的时候变得更加容易扩展。
Labs表示, 这种方法还能减少对共享可变内存、复杂缓存层次结构和缓存一致性机制的需求。每个值都只有一个所有者, 计算则通过连接节点之间的本地交互完成。程序使用该公司开发的Vine语言编写,其语法类似于Rust, 并被编译成一种名为Ivy的中间表示形式。
该公司讲了一下, 说它的这个人工智能系统在没有预先知道任何架构信息的情况下探索了架构方面的事宜。迭代的过程涉及到了编译器, 指令集架构, 微架构, 还有RTL、验证, 以及最终的GDS布局。
这个过程用了一些正式化的、机器能够进行验证的规范内容, 同时也用到了一整套的多智能体集群。系统在四轮搜索里面和最后一轮测试当中总共考虑了58个提案。公司旗下的那个Labs部门表示最后保留了37个提案作为结束结果。
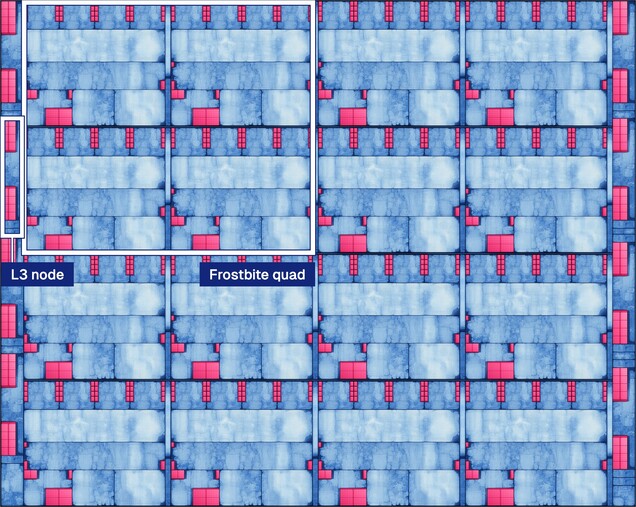
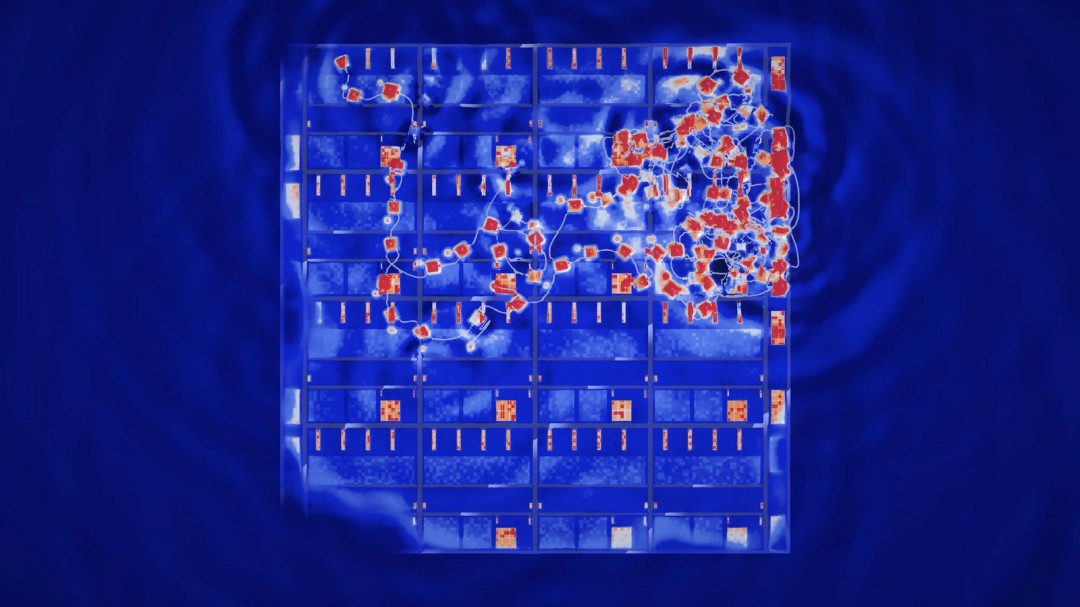
它的七纳米布局采取的是四乘四的网格方式, 并且突出了显示出了一个二乘二的四边形和一个L3节点。
为了开展性能评估工作, Labs团队使用了7纳米工艺技术来合成这个内核设计。在此过程中, 该设计的频率达到了一个特定值, 而当实现最终物理布局的时候, 其运行的频率又是另一个数值。
这样一个由计算单元构成的大模块名叫Quad, 它里面包含了四个排列成两行两列网格形态的计算块, 同时还拥有四个属于第三级高速缓存的节点部分, 所有这些组合在一起占据的空间大小是0.792平方毫米。
作为对比存在的一个CPU内核被称为TCPU, 这家公司给它的称呼就是这么叫, 不过用的是相同的工艺手段去制造的, 它所占据的面积则是0.895平方毫米。由于法律的缘由, Lab这个机构并没有把那些和它的处理器有竞争关系的处理器的具体身份给公开出来。
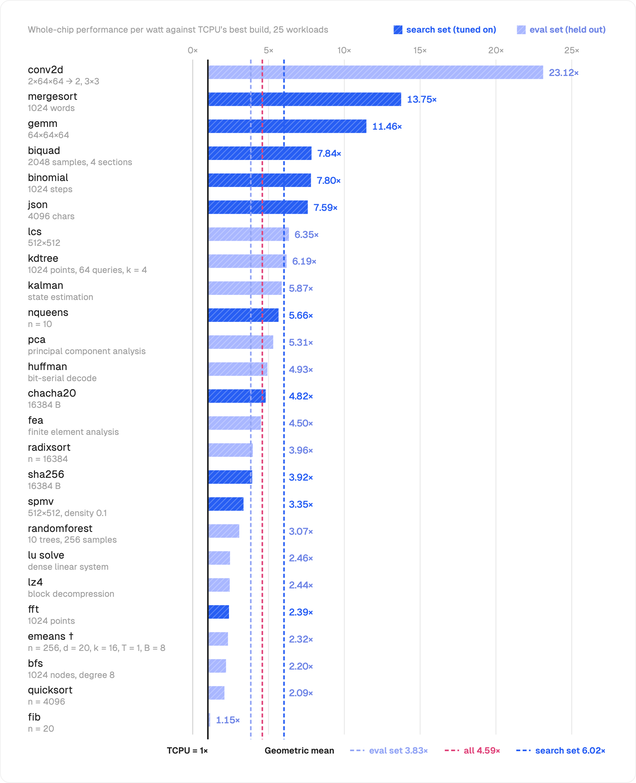
在包括了二十五项的工作负载测试这个情况里面, 架构的每瓦性能几何平均值这一指标, 是参考CPU核心的四点五九倍之多, 并且这个参考对象指的是那个核心的部分, 然后, 就在那些被用于优化过程的十项工作负载测试当中, 其展现出来的优势程度达到了六点零二倍这个数值, 与此同时, 在最后进行评估之前所保留下来的十五项工作负载测试里, 其优势水平达到了三点八三倍的样子, 此外该企业在报告的说明中还提到了一件事情, 那就是其单位面积性能方面, 优势最高可以到达八点七七倍那么高。
当对比架构在传统CPU方面的每瓦性能表现时, 其测试结果是基于二十五种工作负载来进行展开的。对于数据的具体展示方面采用了虚线这种方式分别来标示出来, 它们各自代表了搜索集、保留集以及所有的工作负载情况对应的几何平均值。
Labs这个团队表示, 性能之所以得到了提升, 主要是因为内存流量减少了, 还有指令开销也降低了。测试结果因为工作负载的不同而出现了显著的差异。在那些高度并行的任务方面, 表现可以说是特别出色。
Labs这边还指出, 它们在分支和动态工作负载这两块领域里,也比那个参考核心要好出不少。这家公司打算把这个测试的范围进行扩展, 要把像SPEC这样的行业标准测试以及一些基准测试都纳入进来, 并且还要跟那些规模更大、更宽、而且具备乱序执行功能的CPU设计去作比较。
虽然取得的成果让人看了觉得很满意, 但是整个架构还处在实验的阶段它并不是那种已经可以大规模生产出来的处理器。Labs这家公司没有对外公布过关于这枚芯片什么时候能够进入量产环节或者什么时候会上架销售的计划。
他们打算发布RTL文件还有指令集架构也就是ISA, 接着去搭建一个基于FPGA的软件测试平台, 然后开始开发初步的操作系统, 同时会使用SPEC这类行业标准基准测试工具来进行工作, 目的就是为了把规模更大一点的配置以及多核CPU之间的性能拿出来进行对比分析。
© 版权声明
文章版权归作者所有,未经允许请勿转载。